Ein KI-Benchmark, auch LLM-Benchmark genannt, ist ein standardisierter Test für große Sprachmodelle (Large Language Models, kurz LLM): Alle Modelle bearbeiten dieselben Aufgaben, bewertet wird nach denselben Regeln. Das Ergebnis ist eine Punktzahl, die sich in einer Rangliste (englisch: Leaderboard) vergleichen lässt.
Für Ihre Entscheidungsfindung reicht diese Zahl allein nicht. Sie beschreibt ein Sprachmodell unter theoretischen Prüfungsbedingungen, während Sie mit einem fertigen Produkt im Alltag arbeiten, dessen Funktionen und Regeln Ranglisten kaum erfassen.
Benchmark für KI-Modelle: drei Arten von Tests
Hinter dem Wort Benchmark stehen sehr unterschiedliche Prüfungen. Drei Gruppen begegnen Ihnen in fast jeder Rangliste.
Testart
Bekannte Beispiele
So wird gemessen
Aussage für Ihren Alltag
Wissens- und Denkaufgaben
MMLU, GPQA, Humanity's Last Exam, ARC-AGI
Feste Aufgaben mit eindeutig richtiger Lösung
Zeigt Fachwissen und Logik, wenig über Schreibstil oder den Umgang mit Ihren Unterlagen
Blindvergleich durch Menschen
Arena (früher LMArena)
Zwei anonyme Antworten, Menschen wählen die bessere
Zeigt, welche Antworten gefallen. Ob sie inhaltlich stimmen, fließt nicht gesondert in die Wertung ein
Praxis- und Agentenaufgaben
SWE-bench, τ-bench
Das Modell erledigt mehrstufige Aufträge, etwa einen Softwarefehler beheben oder eine Kundenanfrage lösen
Am nächsten an echter Arbeit, aber auf wenige Berufsfelder begrenzt
Viele Ranglisten rechnen mehrere dieser Tests zu einem Gesamtwert zusammen, etwa der Intelligence Index von Artificial Analysis. Das ist bequem, verdeckt aber, wo ein Modell stark ist und wo nicht.
Die dritte Gruppe gewinnt an Bedeutung, weil KI-Systeme immer öfter mehrere Arbeitsschritte selbstständig ausführen. Mehr erfahren Sie auf Was sind KI-Agenten.
KI-Benchmark-Vergleich und LLM-Rankings lesen: fünf Prüfpunkte
Ein KI-Benchmark-Vergleich wirkt eindeutig: Platz eins, Platz zwei, Platz drei. Fünf Prüfpunkte zeigen, wie viel die Reihenfolge für Sie bedeutet.
Welche Aufgabe wurde geprüft? Ein Spitzenwert im Programmieren hilft nicht beim Formulieren von Angeboten. Suchen Sie die Wertung, die Ihrer Arbeit am nächsten kommt.
Wer hat gemessen? KI-Unternehmen veröffentlichen zum Start eines Modells vor allem die Tests, in denen es gut abschneidet. Unabhängige Messungen sind die bessere Quelle, etwa Arena, Artificial Analysis oder Epoch AI.
Wie groß ist der Abstand? Viele Ranglisten geben eine Schwankungsbreite an. Überschneiden sich die Spannen zweier Modelle, ist die Reihenfolge offen. Im Alltag fallen solche Unterschiede kaum auf.
Wie alt ist der Wert? Prüfen Sie Datum und Modellversion. Ein Ergebnis von vor sechs Monaten beschreibt oft ein Modell, das das Unternehmen bereits ersetzt hat.
Ist der Test ausgereizt? Erreichen alle vorderen Plätze fast die volle Punktzahl, trennt der Test nicht mehr. Mehr dazu unter Der Test ist zu leicht geworden.
Grenzen von KI-Benchmarks
Benchmarks sind nützlich für eine erste Vorauswahl. Als alleinige Entscheidungsgrundlage taugen sie wenig.
Viele Testaufgaben sind öffentlich und können ins Trainingsmaterial neuer Modelle gelangen. Fachleute nennen das Kontamination: Das Modell hat die Prüfung gesehen, bevor es sie ablegt. OpenAI weist beispielsweise seit Februar 2026 für den Programmiertest SWE-bench Verified keine Werte mehr aus, nachdem eine eigene Prüfung fehlerhafte Aufgaben und aus dem Training bekannte Lösungen gezeigt hatte.
Der Wissenstest MMLU galt lange als Maßstab, bis die führenden Modelle fast alle Fragen richtig beantworteten. Als Antwort entstanden schwerere Prüfungen, etwa Humanity's Last Exam mit 2.500 Fragen, die Fachleute aus vielen Disziplinen beigesteuert haben. Auch diese Tests werden irgendwann ausgereizt sein.
Ein Forschungsteam um das Oxford Internet Institute hat 2025 insgesamt 445 Benchmarks untersucht. Nur 16 Prozent nutzten statistische Verfahren, um Modelle zu vergleichen. Rund die Hälfte wollte abstrakte Begriffe messen, z. B. "logisches Denken", ohne sie klar zu definieren.
Beim Blindvergleich stimmen Menschen über ihren Eindruck ab. Eine ausführliche, sicher und selbstbewusst formulierte Antwort kann gewinnen, obwohl sie Fehler enthält. Arena rechnet Länge und Formatierung inzwischen statistisch heraus. Ein Faktencheck der Antworten ist das nicht.
Was Ranglisten auslassen
Ranglisten bewerten das Sprachmodell. Diese fünf Eigenschaften des fertigen Produkts erfassen sie kaum:
Datenverarbeitung: Wo werden Ihre Eingaben gespeichert, und fließen sie in das Training ein? Dasselbe Modell kann in zwei Produkten stecken, die diese Fragen unterschiedlich beantworten. Sobald Sie Kundendaten eingeben, wiegt dieser KI-Datenschutz schwerer als ein Platz in der Rangliste.
Nutzungsgrenzen: Ein starkes Modell nützt wenig, wenn der Tarif die Zahl der Nachrichten begrenzt. Benchmarks laufen ohne solche Grenzen. Im Alltag greift ein Limit, z. B. mitten in der Überarbeitung eines Angebots, oder das Produkt wechselt ab einer bestimmten Menge auf ein schwächeres Modell.
Wissensquellen: Websuche und Dokumenten-Upload entscheiden, ob die Antwort über den Trainingsstand hinausreicht. Wissenstests prüfen das Modell in der Regel ohne diese Werkzeuge. Fragen Sie etwa nach einer Förderrichtlinie aus dem laufenden Jahr, hängt die Antwort an der Suche und nicht am Testergebnis.
Deutsche Sprache: Die bekannten Ranglisten prüfen überwiegend auf Englisch. Die üblichen Tücken einer Übersetzung bleiben so unsichtbar, beispielsweise wörtlich übertragene Redewendungen, ein Wechsel zwischen Sie und Du etc.
Kosten: Ranglisten vergleichen, wenn überhaupt, API-Preise pro Token, nicht den Monatspreis eines Abos. Ein Token ist ein Wortbaustein, nach dem KI-Unternehmen die Nutzung über eine Programmierschnittstelle (API) abrechnen. Für die Arbeit im Chat zählt dagegen, was ein Tarif im Monat kostet und was er enthält.
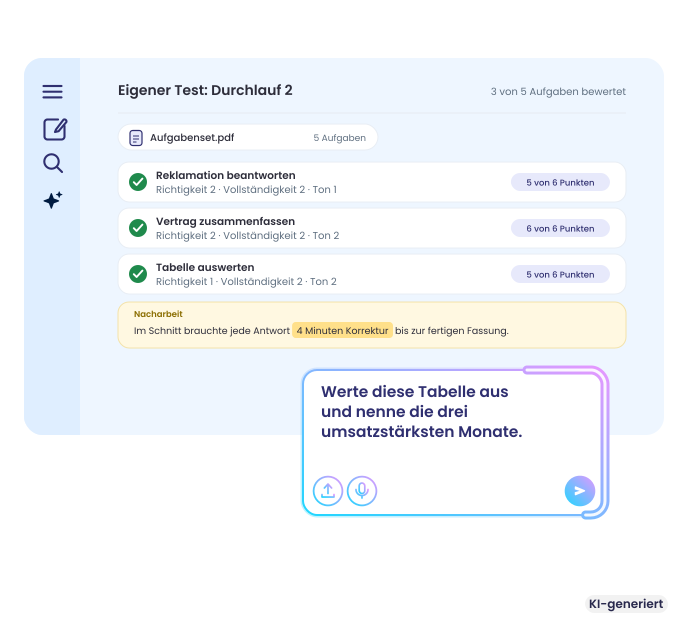
Was einen Benchmark ausmacht, lässt sich ohne Programmierkenntnisse nachbauen: gleiche Aufgaben, gleiche Bewertung, wiederholbar. In fünf Schritten entsteht Ihr eigener Test.
Aufgaben sammeln: Wählen Sie fünf bis zehn Aufgaben aus Ihrer letzten Arbeitswoche. Beispielsweise die Antwort auf eine Reklamation, die Zusammenfassung eines Vertrags oder die Auswertung einer Tabelle.
Bewertung vorher festlegen: Notieren Sie pro Aufgabe, was eine gute Antwort enthält. Vergeben Sie danach null bis zwei Punkte für Richtigkeit, Vollständigkeit und Ton.
Gleiche Bedingungen schaffen: Nutzen Sie für jeden Kandidaten denselben Wortlaut, einen neuen Chat und dieselben Unterlagen.
Blind bewerten: Kopieren Sie die Antworten ohne Namen in ein Dokument und lassen Sie eine zweite Person aus dem Team urteilen. Anders als beim Blindvergleich der großen Ranglisten bewerten Sie nach den Kriterien aus Schritt 2, nicht nach Eindruck.
Wiederholen: Stellen Sie dieselben Aufgaben an einem anderen Tag noch einmal. Schwankt die Qualität stark, ist das ein Ergebnis für sich.
Notieren Sie zusätzlich, wie viele Minuten Nacharbeit jede Antwort braucht. Diese Zahl sagt oft mehr über den Nutzen aus als ein Punktwert. Für Aufgaben mit Quellenarbeit gibt es einen eigenen Selbsttest auf Beste KI für Recherche.
Heben Sie Ihr Aufgabenset auf. Erscheint ein neues Modell oder wechseln Sie zu einem anderen KI-Unternehmen, lassen Sie dieselben Aufgaben erneut laufen. So vergleichen Sie über Monate hinweg mit dem gleichen Maßstab.
Smart KI
STRATO GPT
5 €/Mon.
1. Monat gratis
Smart KI
STRATO GPT
0 €/Mon.
1. Monat gratis
danach 4 €/Mon.
Preise inkl. MwSt.
STRATO GPT mit eigenen Aufgaben testen
STRATO GPT ist ein KI-Chat-Assistent, den Sie im Browser nutzen, ohne etwas zu installieren. Im Tarif mit 12 Monaten Laufzeit ist der erste Monat gratis. Das reicht, um Ihr Aufgabenset aus dem Selbsttest mehrfach durchlaufen zu lassen.
Für den Test sind diese Funktionen relevant:
Dokumenten-Upload: Sie prüfen mit den Verträgen, Tabellen und Berichten, die Sie später auch bearbeiten. Ihre Daten werden DSGVO-konform verarbeitet und nicht für das Training von KI-Modellen verwendet.
Denkmodus: Über das Gehirn-Symbol "Nachdenken" schalten Sie den Denkmodus ein. Die KI zerlegt die Aufgabe dann in Zwischenschritte und braucht dafür länger. Stellen Sie dieselbe Aufgabe einmal mit und einmal ohne Denkmodus und vergleichen Sie beide Antworten.
Keine monatlichen Limits: Wiederholungen gehören zu jedem sauberen Test. Bei STRATO GPT chatten Sie ohne monatliche Nutzungsgrenze, auch im Denkmodus.
Websuche: Für Aufgaben mit aktuellem Bezug schalten Sie die Websuche ein und prüfen, ob die genannten Quellen die Aussagen tragen.
Wissensdatenbank: Unterlagen, die Sie in mehreren Testläufen brauchen, legen Sie einmal ab und binden sie mit einem # in jeden Chat ein.
Hardware-Benchmarks, etwa MLPerf oder Geekbench AI, messen, wie schnell ein Prozessor oder eine Grafikkarte KI-Berechnungen ausführt. Sie sind für alle relevant, die KI-Modelle auf eigenen Geräten betreiben. Über die Qualität der Antworten sagen sie nichts aus. Nutzen Sie einen KI-Assistenten im Browser, spielt die Hardware Ihres Rechners keine Rolle.
Elo ist ein Wertungssystem aus dem Schach. Im Blindvergleich gewinnt ein Modell Punkte, wenn Menschen seine Antwort der eines anderen vorziehen. Der Abstand zweier Werte drückt aus, wie oft das eine Modell im direkten Vergleich vorn liegt. Überschneiden sich die angegebenen Schwankungsbreiten zweier Modelle, ist der Abstand nicht aussagekräftig.
Arena veröffentlicht die Ergebnisse seines Blindvergleichs. Artificial Analysis kombiniert mehrere Tests zu einem Index und zeigt zusätzlich Tempo und API-Preise. Epoch AI sammelt Ergebnisse anspruchsvoller Einzeltests und führt eigene Messungen durch. Achten Sie bei allen auf das Datum der letzten Aktualisierung.
Die großen Ranglisten werden laufend aktualisiert, weil KI-Unternehmen in kurzen Abständen neue Modellversionen veröffentlichen. Die Spitze wechselt deshalb mehrmals im Jahr. Ein eigenes Aufgabenset bleibt brauchbar, solange sich Ihre Aufgaben nicht wesentlich ändern.
Ja, meist als übersetzte Fassungen englischer Tests, etwa des Wissenstests MMLU in seiner mehrsprachigen Version. Solche Aufgaben prüfen Fachwissen, aber kaum Stil, Anrede oder die Fachsprache Ihrer Branche. Aussagekräftiger ist deshalb ein Test mit Ihren eigenen deutschen Texten, beispielsweise einem Geschäftsbrief mit mehreren Rückfragen. Sechs Prüfaufgaben dafür finden Sie auf Chatbot auf Deutsch.